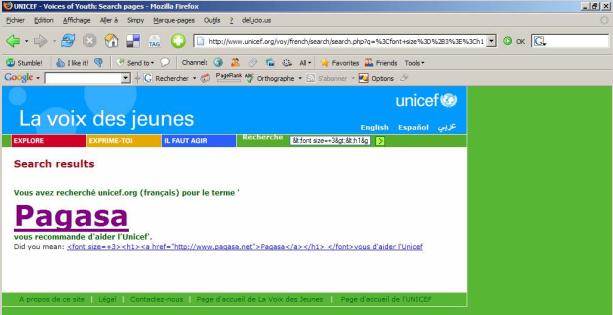
Notre petit périple au pays du Blackhat nous a conduit à voir comment créer un lien avec un site populaire au moyen d’une injection d’URL. Je vous ai également parlé de ces spammeurs de liens qui gagnent beaucoup d’argent grâce à des techniques de programmation sophistiquées. Et finalement, je vous ai fait une petite démonstration sur l’art de spammer subtilement Google. A ce jour, je n’ai d’ailleurs toujours pas été blacklisté chez eux sur le mot clé que je visais: spammeur. Comme c’est étrange, on nous aurait menti ou alors je travaille peut être chez Google ?
Après ces petites histoires qui nous ont tous bien amusé, je m’attaque à un autre sujet qui se situe toujours dans la mouvance Blackhat: le scraping. Pour cela, je me ferai aider par un assistant dont on entend beaucoup parler en ce moment:
Sébastien Chabal, le fameux joueur de rugby qui fait le désespoir des coiffeurs.
Le scraper est celui (la personne ou le programme) qui fait le scraping. Je vais expliquer en quoi cela consiste un peu plus tard.
Dans mes autres articles, je me suis focalisé sur la manière de populariser mes sites. Néanmoins, lorsque je crée 1000 sites, si je n’ai pas trop de problèmes à les faire connaà®tre, j’ai tout de même un souci de taille: où vais-je donc trouver tout le contenu ?
Car pour être rentable, je dois créer des dizaines, voir même des centaines de pages par site. En clair, il me faut des millions de pages à faire digérer par Google.
Je pourrai engager un indien qui m’écrirait des dizaines d’articles pour quelques dollars, mais cela demande du temps: chercher, poster, négocier, payer, uploader, etc. Bref, cela finirait par me coà»ter un peu cher et mon ROI ne serait certainement pas atteint.
Finalement, comme je m’y connais un peu en programmation, j’ai décidé de faire travailler un peu ma machine, c’est tellement plus simple et surtout moins fatiguant.
En cherchant un peu, je me suis rendu compte de deux choses.
Tout d’abord, tous les jours, des milliers de personnes blogguent des petites bafouilles sur leur vie, leur petites misères et leur passion. Dans ce gigantesque amas d’écrits de plus ou moins bonne facture, je dispose d’un énorme vivier de contenu extrêmement dynamique que je vais récupérer pour mon propre intérêt.
Ensuite, tous les moteurs de recherche ont leur rubrique d’actualités qui contient également une montagne d’écrits qui m’intéressent (On dira plutôt qui intéresse notre ami Google). Maintenant, on pourrait se demander pourquoi ne pas prendre tout simplement des résultats conventionnels de requêtes que l’on mettra en forme.
Non, car les blogs et les actualités évoluent plus rapidement que les bêtes SERPS et risque de beaucoup plus intéresser Google, toujours avide de nouvelles informations et prêt à surgir à chaque mise à jour de mon site.
Donc, pour résumer, moi le scraper, je vais aller piquer du contenu chez les bloggeurs et dans les rubriques d’actualité. Je vais ensuite tout remettre en forme et ajouter des Adsense ou des liens d’affiliation dans les pages ainsi générées. C’est cela le scraping: voler les informations des autres pour construire son propre site.
En guise de démonstration, je vous ai concocté rapidement une petite page scrapée sur notre chevelu national: l’inénarrable Sébastien Chabal.
J’ai commencé par mettre une petite photo sympa, histoire d’amadouer mes « victimes ». Ce sera d’ailleurs la seule partie statique, tout le reste étant généré à la volée. Ensuite, on trouve un bloc texte, plus ou moins incompréhensible dans lequel on retrouve Sébastien. Ces machins là viennent de mon scraping sur les blogs. Je n’ai pas trop retravaillé le texte, d’où les caractères cabalistiques et puis les quelques textes étrangers qui se sont immiscés, mais peu importe ce qui compte, c’est de donner à manger à Google. La page se termine sur des nouvelles scrapées sur Yahoo.
Voilà , pas mal, non ? En fait, c’est nul à crever, mais c’est juste une démonstration pour que toi, mon troll préféré, comprennent comment s’y prend le scraper; mais sache qu’il n’y a que quelques lignes de codes vite programmées entre deux bières.
Il y a beaucoup de façon d’améliorer la bête. Tout d’abord, je peux récupérer une base de données contenant des expressions toute faites, dotées d’une sémantique irréprochable. Ensuite, j’y insère mon mot clé, vous savez le joueur de rugby qui casse des mâchoires. Eventuellement, je fais quelques retouches en utilisant des synonymes. Je fais une extraction sur une dizaine d’expressions. Le sens n’aura certainement ni queue ni tête (hum, vous pouvez être parfois très surpris du résultat), mais Google n’y verra rien du tout. Après, je peux insérer une petite vidéo toujours récupérée sur Google, histoire de cosmétiser la page.
Et finalement, j’insère sur la page quelques liens comme suit:
sebastien-chabal-rugby-02.php, sebastien-chabal-coupe-monde-03.php, chabal-sebastien-joueur-04.php qui à chaque fois vont être une page différente dont le contenu sera scrapé comme pour la première page. La seule différence notable est que pour l’index, je scrape seulement sur le mot clé primaire, ici « chabal », et que plus je m’enfonce dans le site, et plus je serai précis: je cherche à me positionner sur « sebastien chabal », puis sur « sebastien chabal rugby », etc. Au total si la niche est suffisamment riche, alors je peux espérer créer facilement des milliers de pages à la volée.
Pour terminer, on va encore me soulever la question de l’éthique, de la morale, des droits d’auteurs, du contenu dupliqué, etc.
Sur le fond, il n’y a franchement rien de moral, c’est clair: on fait de l’argent grâce au travail des autres. Je ne m’étendrai pas sur le sujet, le scraper a ses principes, ses objectifs et les moyens qu’il met en oeuvre pour y arriver. La technologie permet certes d’engranger rapidement des bénéfices conséquents, mais à long terme, je doute de la viabilité de ce qui ne sera jamais construit sur un business model cohérent.
Maintenant, comme le disait assez justement Sam: il n’y a rien de personnel dans tout cela.